Контекст
POSUTI помогает работать с содержанием записей: получить полный текст интервью, конспект лекции или итоги встречи. Я основатель продукта и полностью написал сервис — от пользовательского интерфейса до серверной обработки и распознавания речи на Python. Сервис работает в промышленной эксплуатации.
Задача: сделать запись полезной
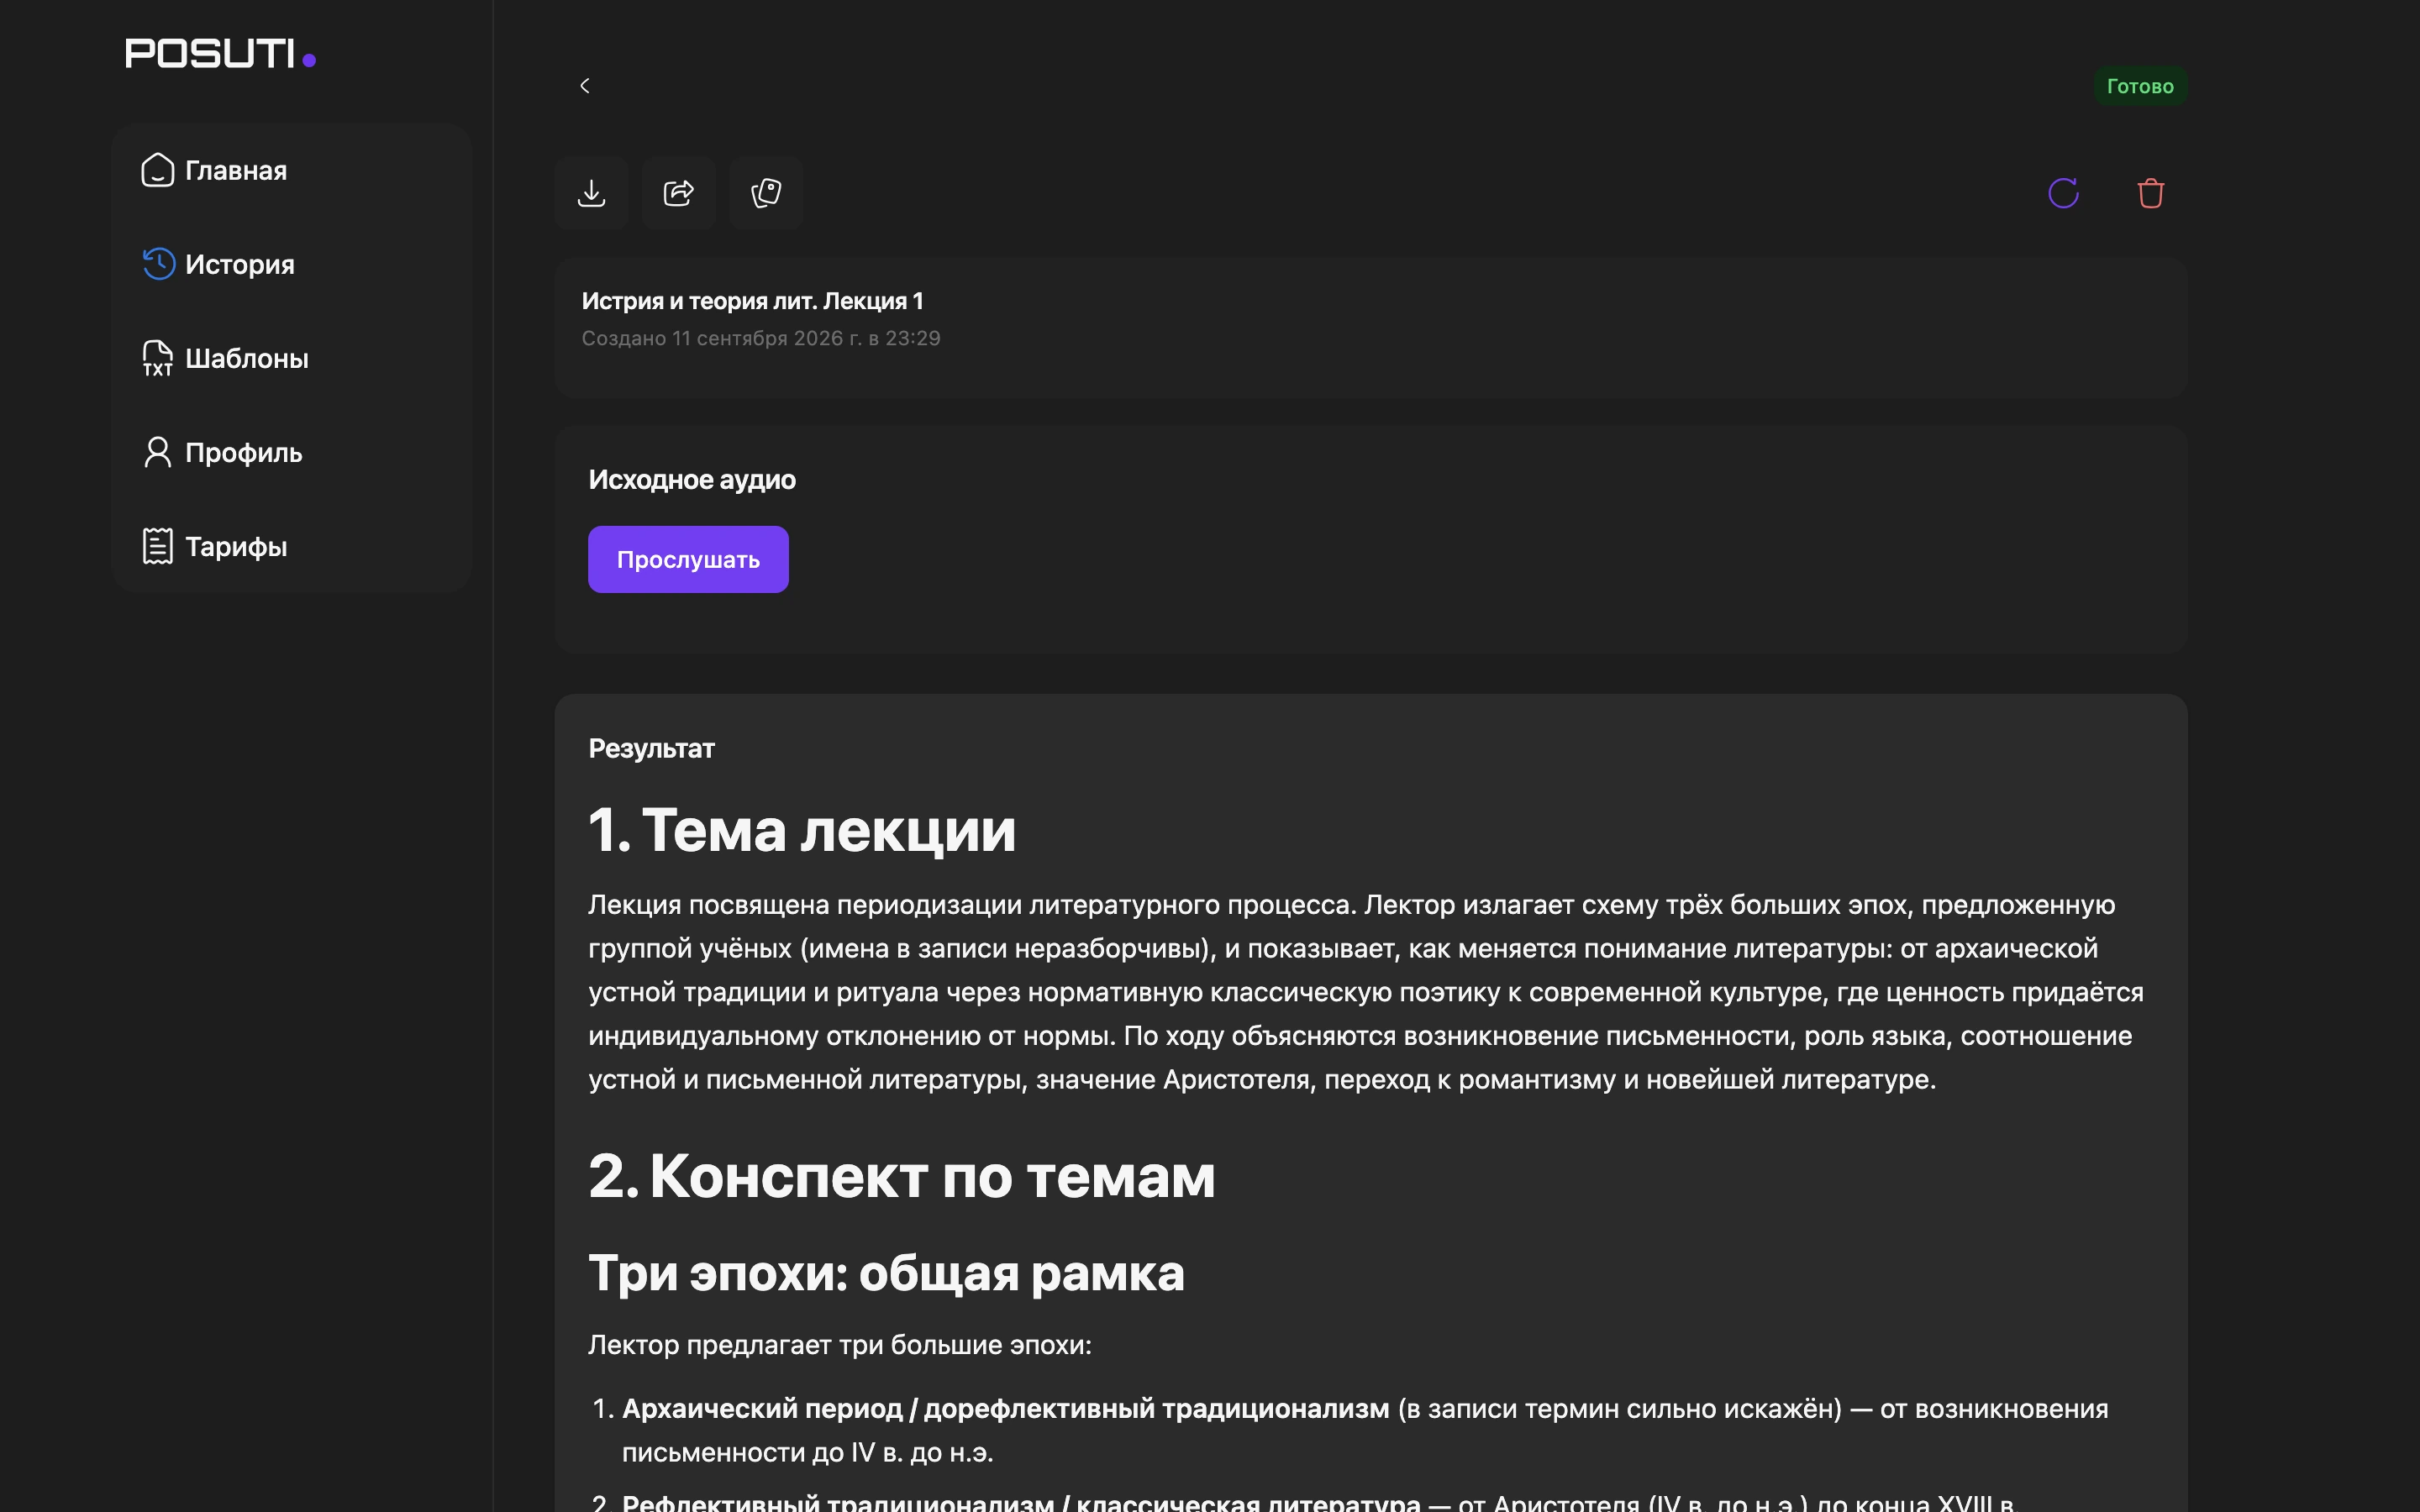
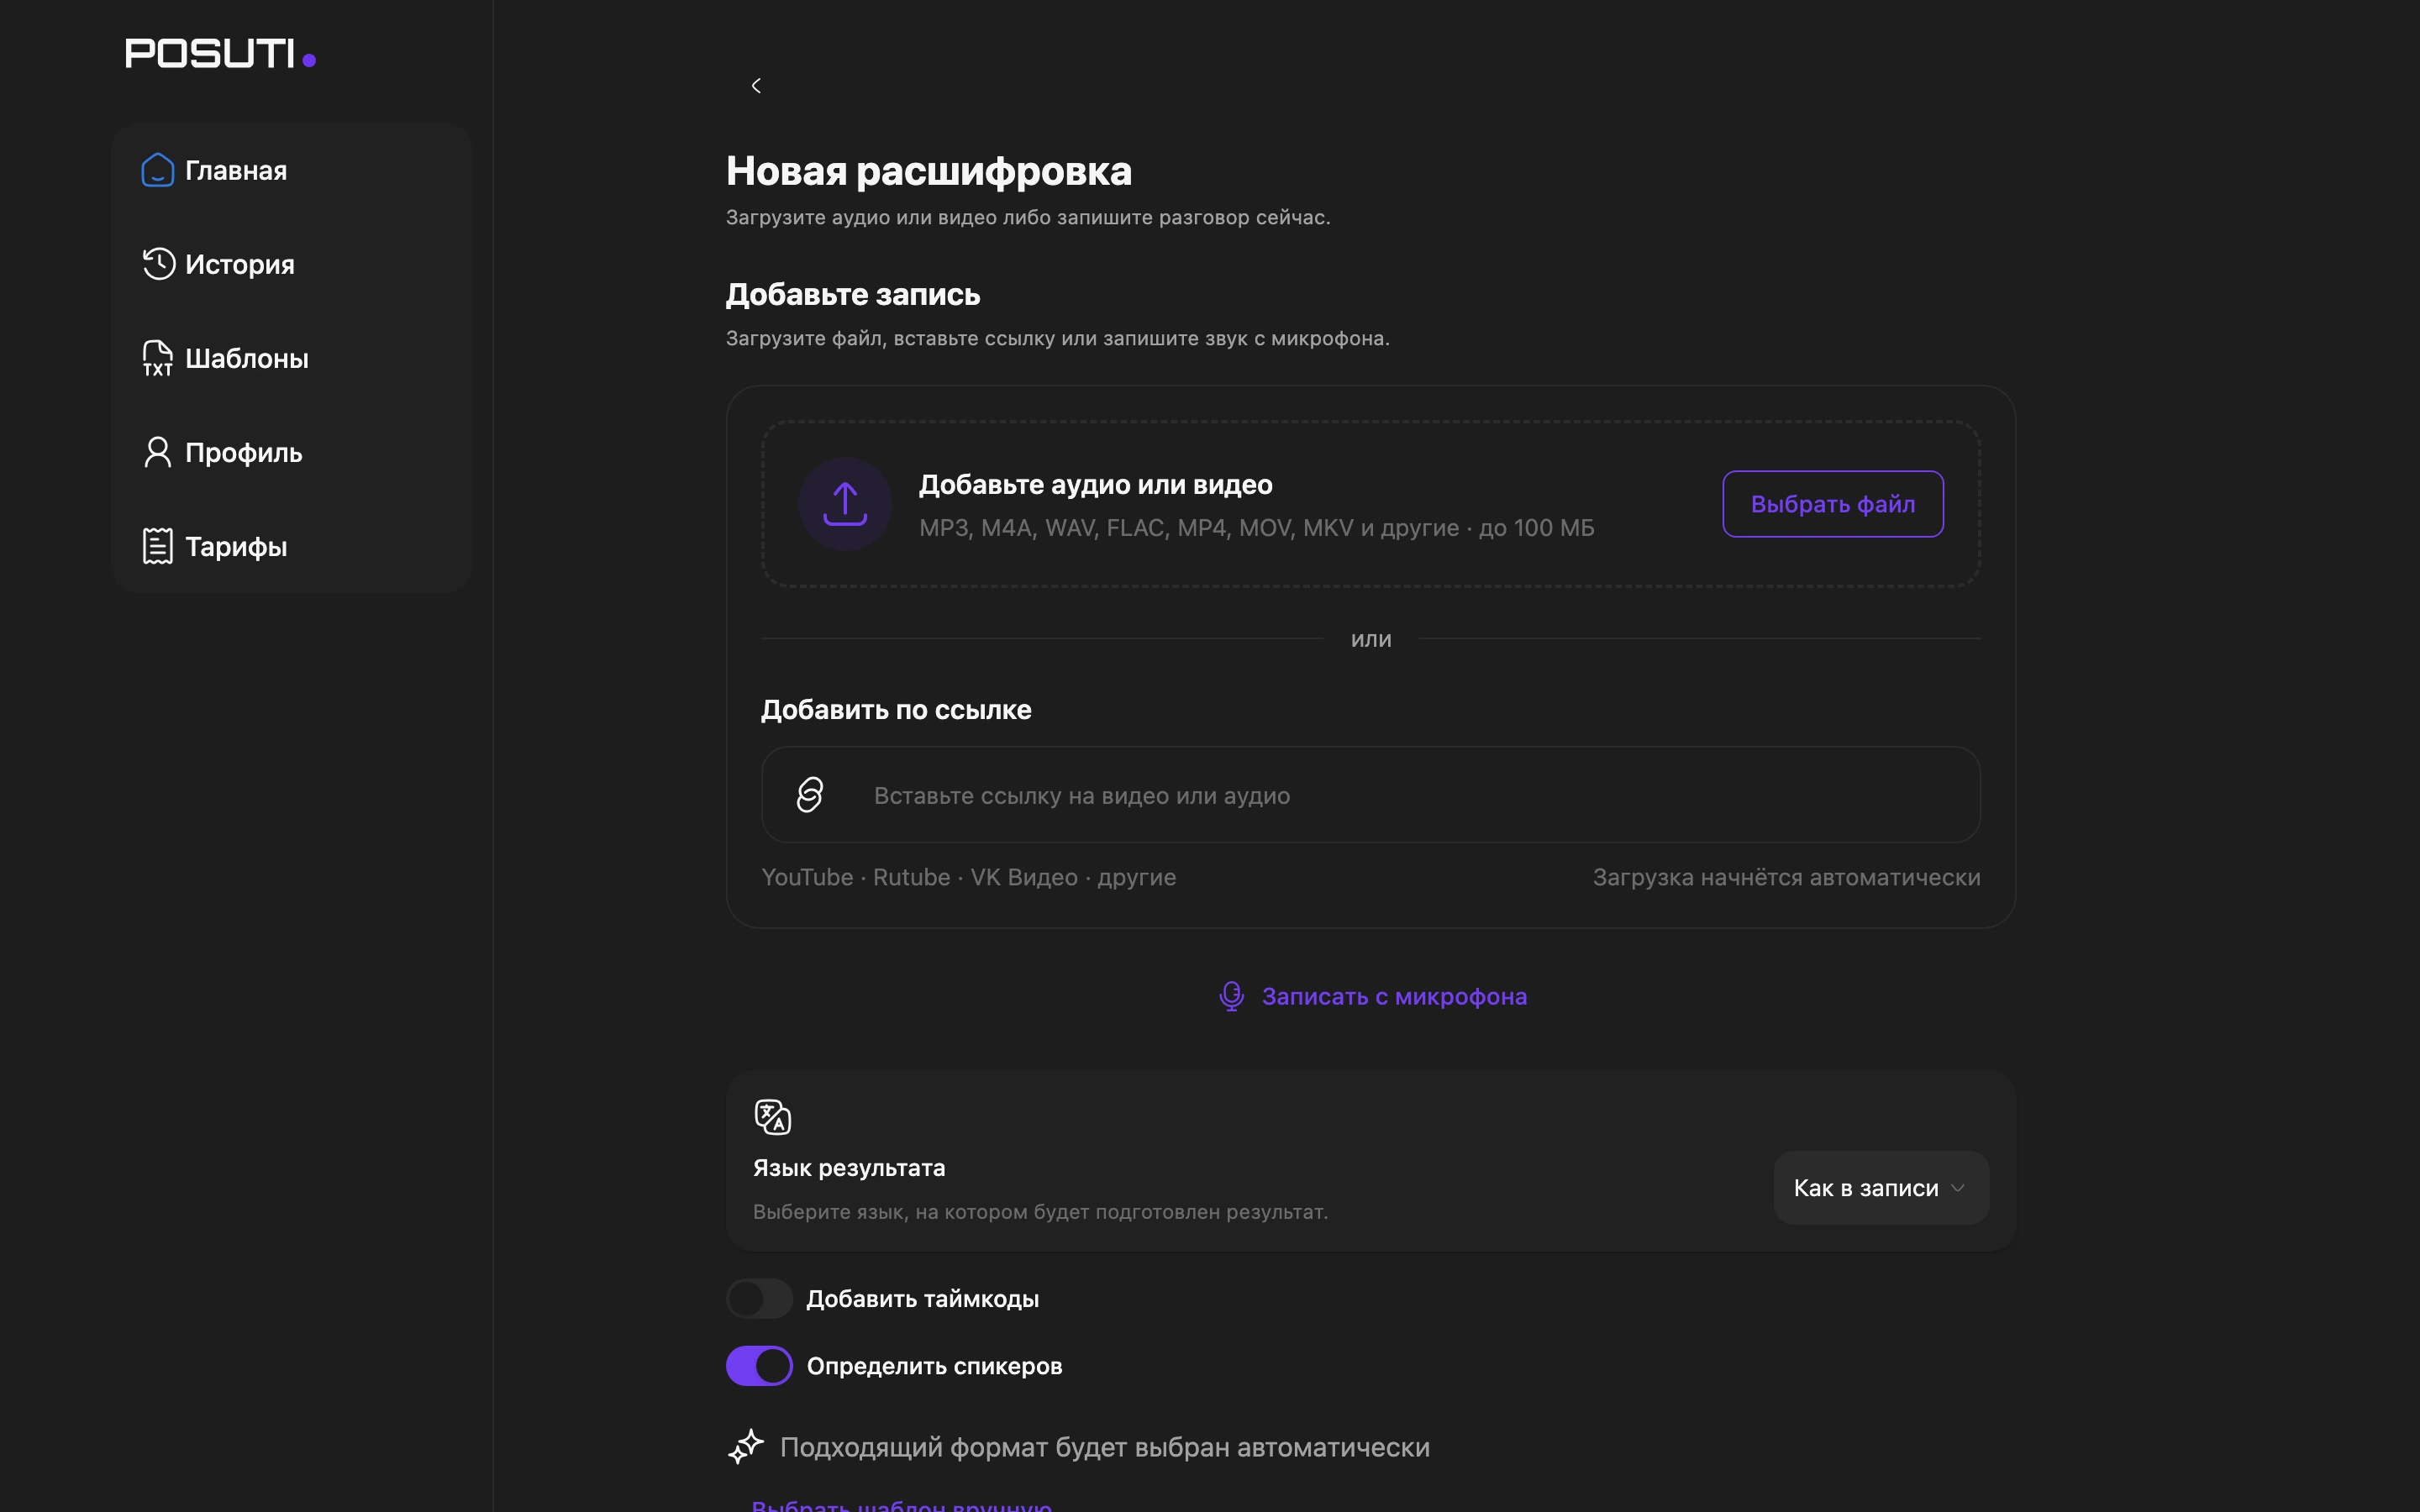
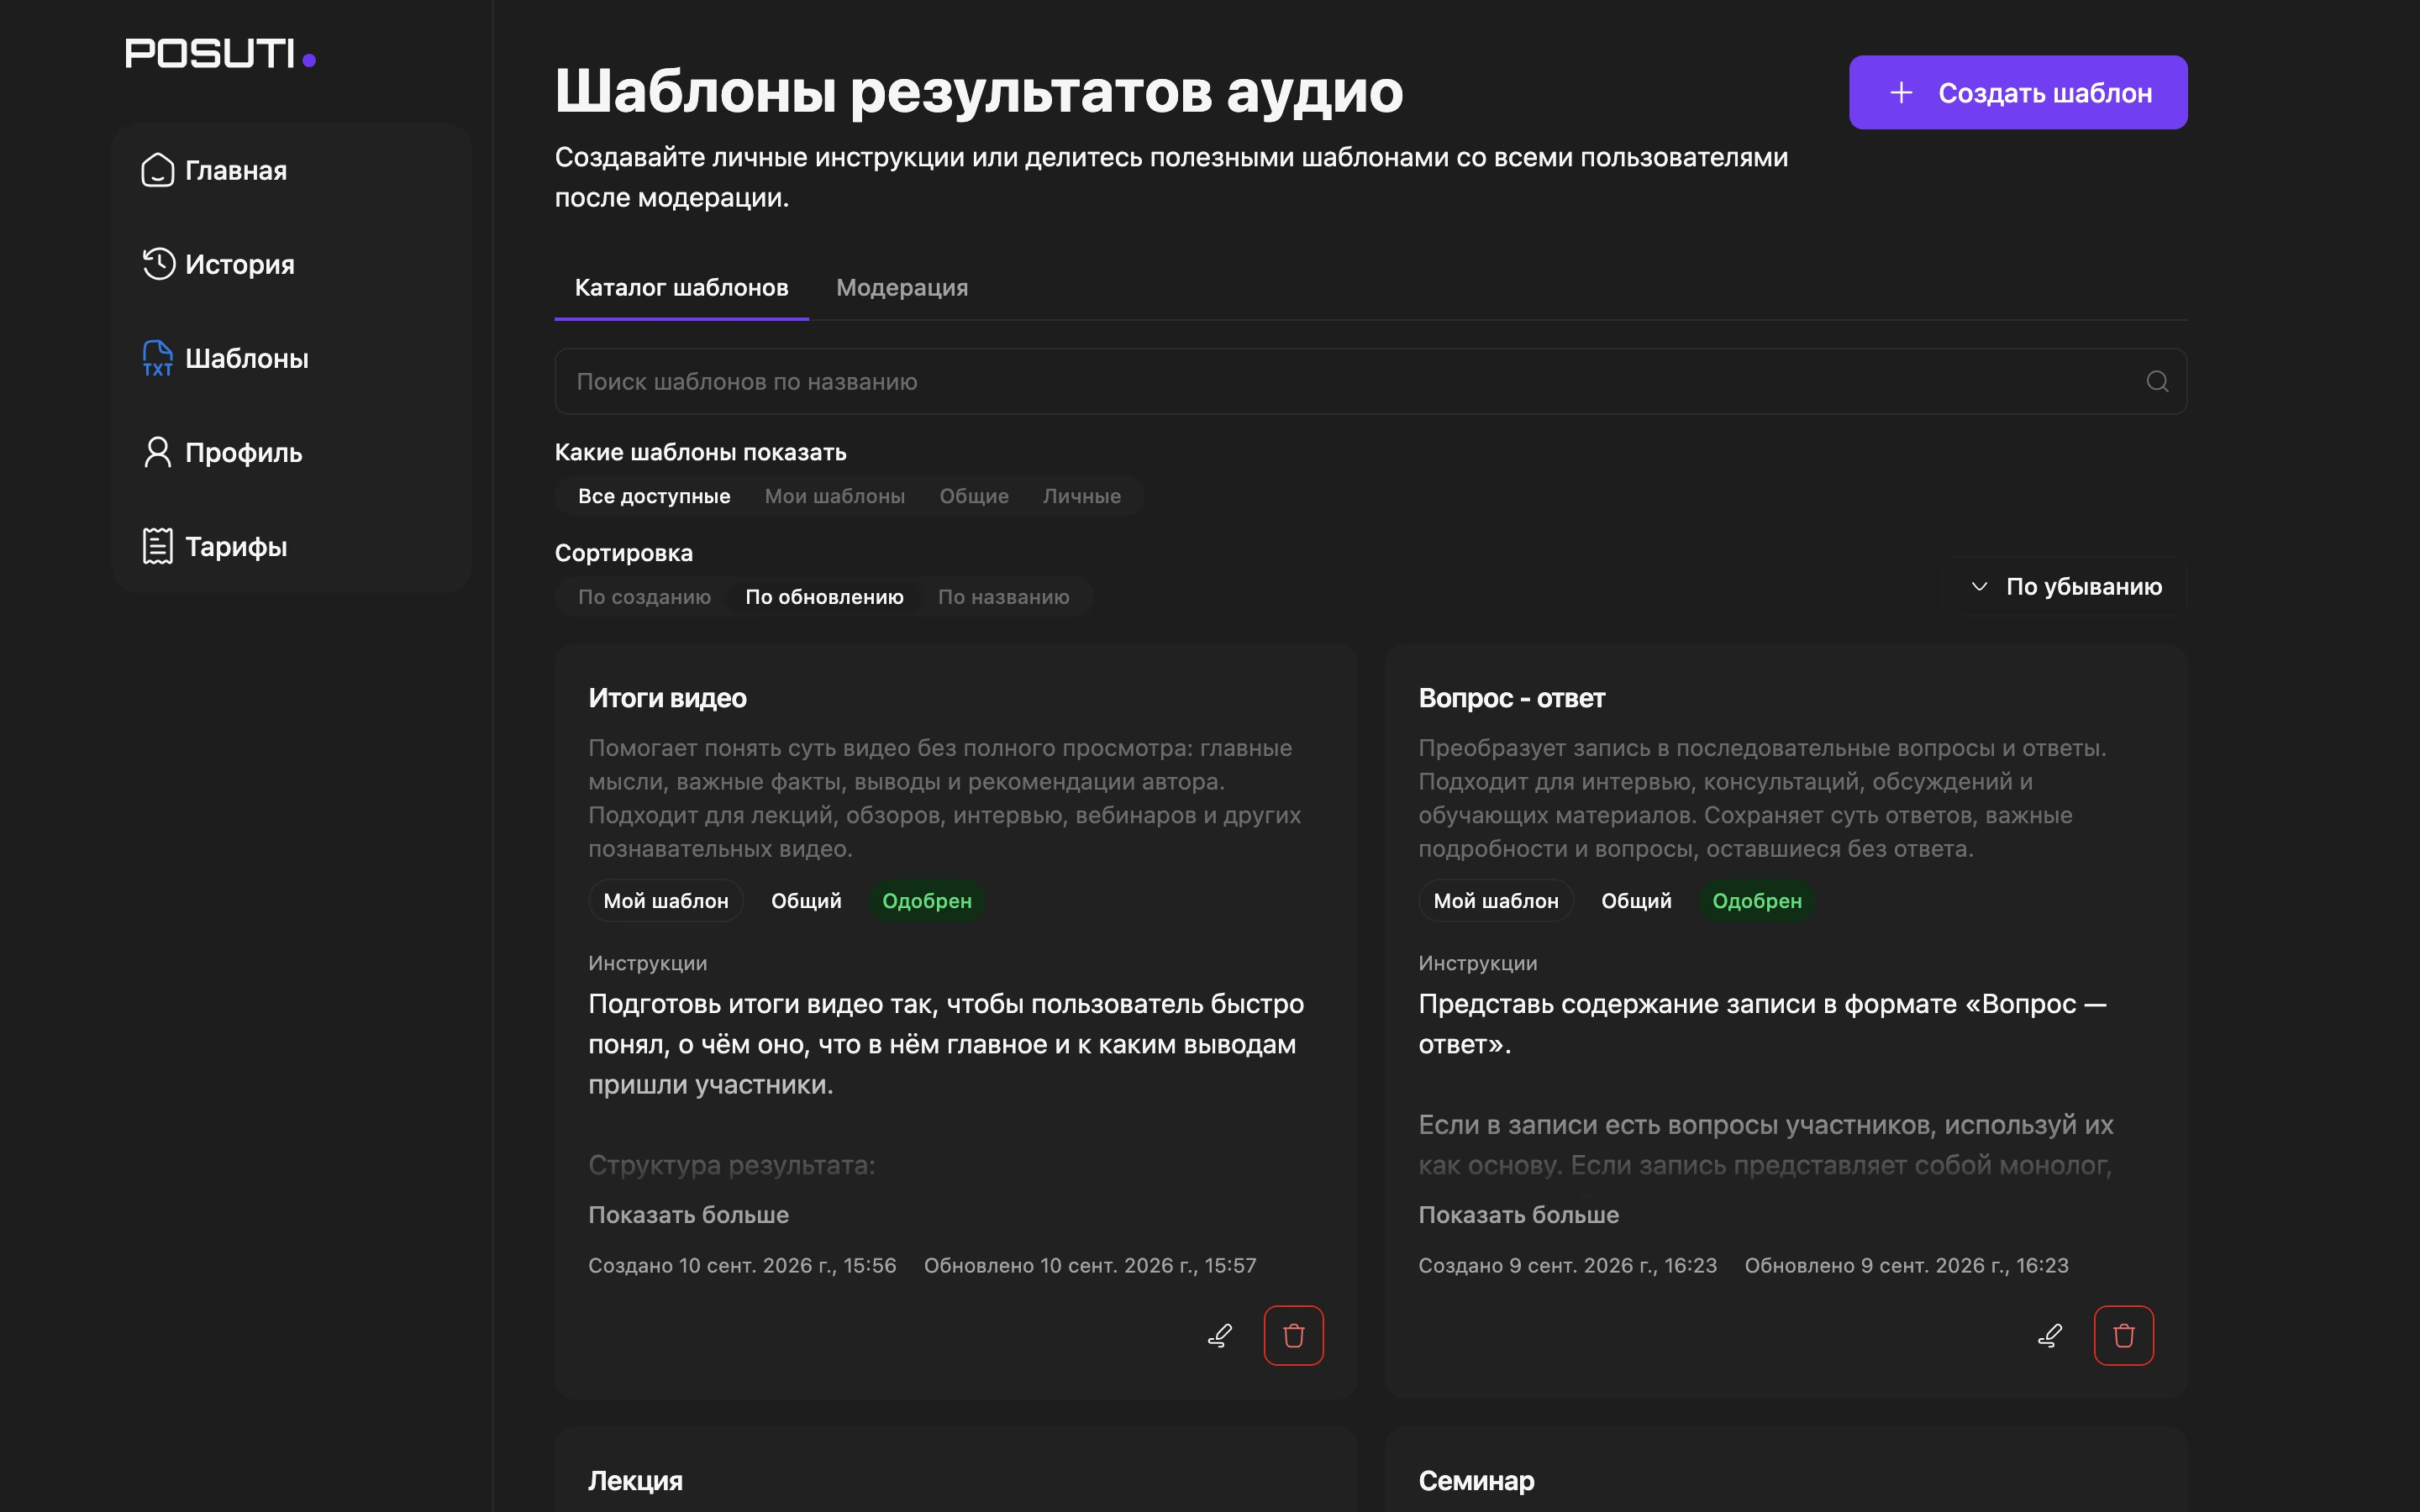
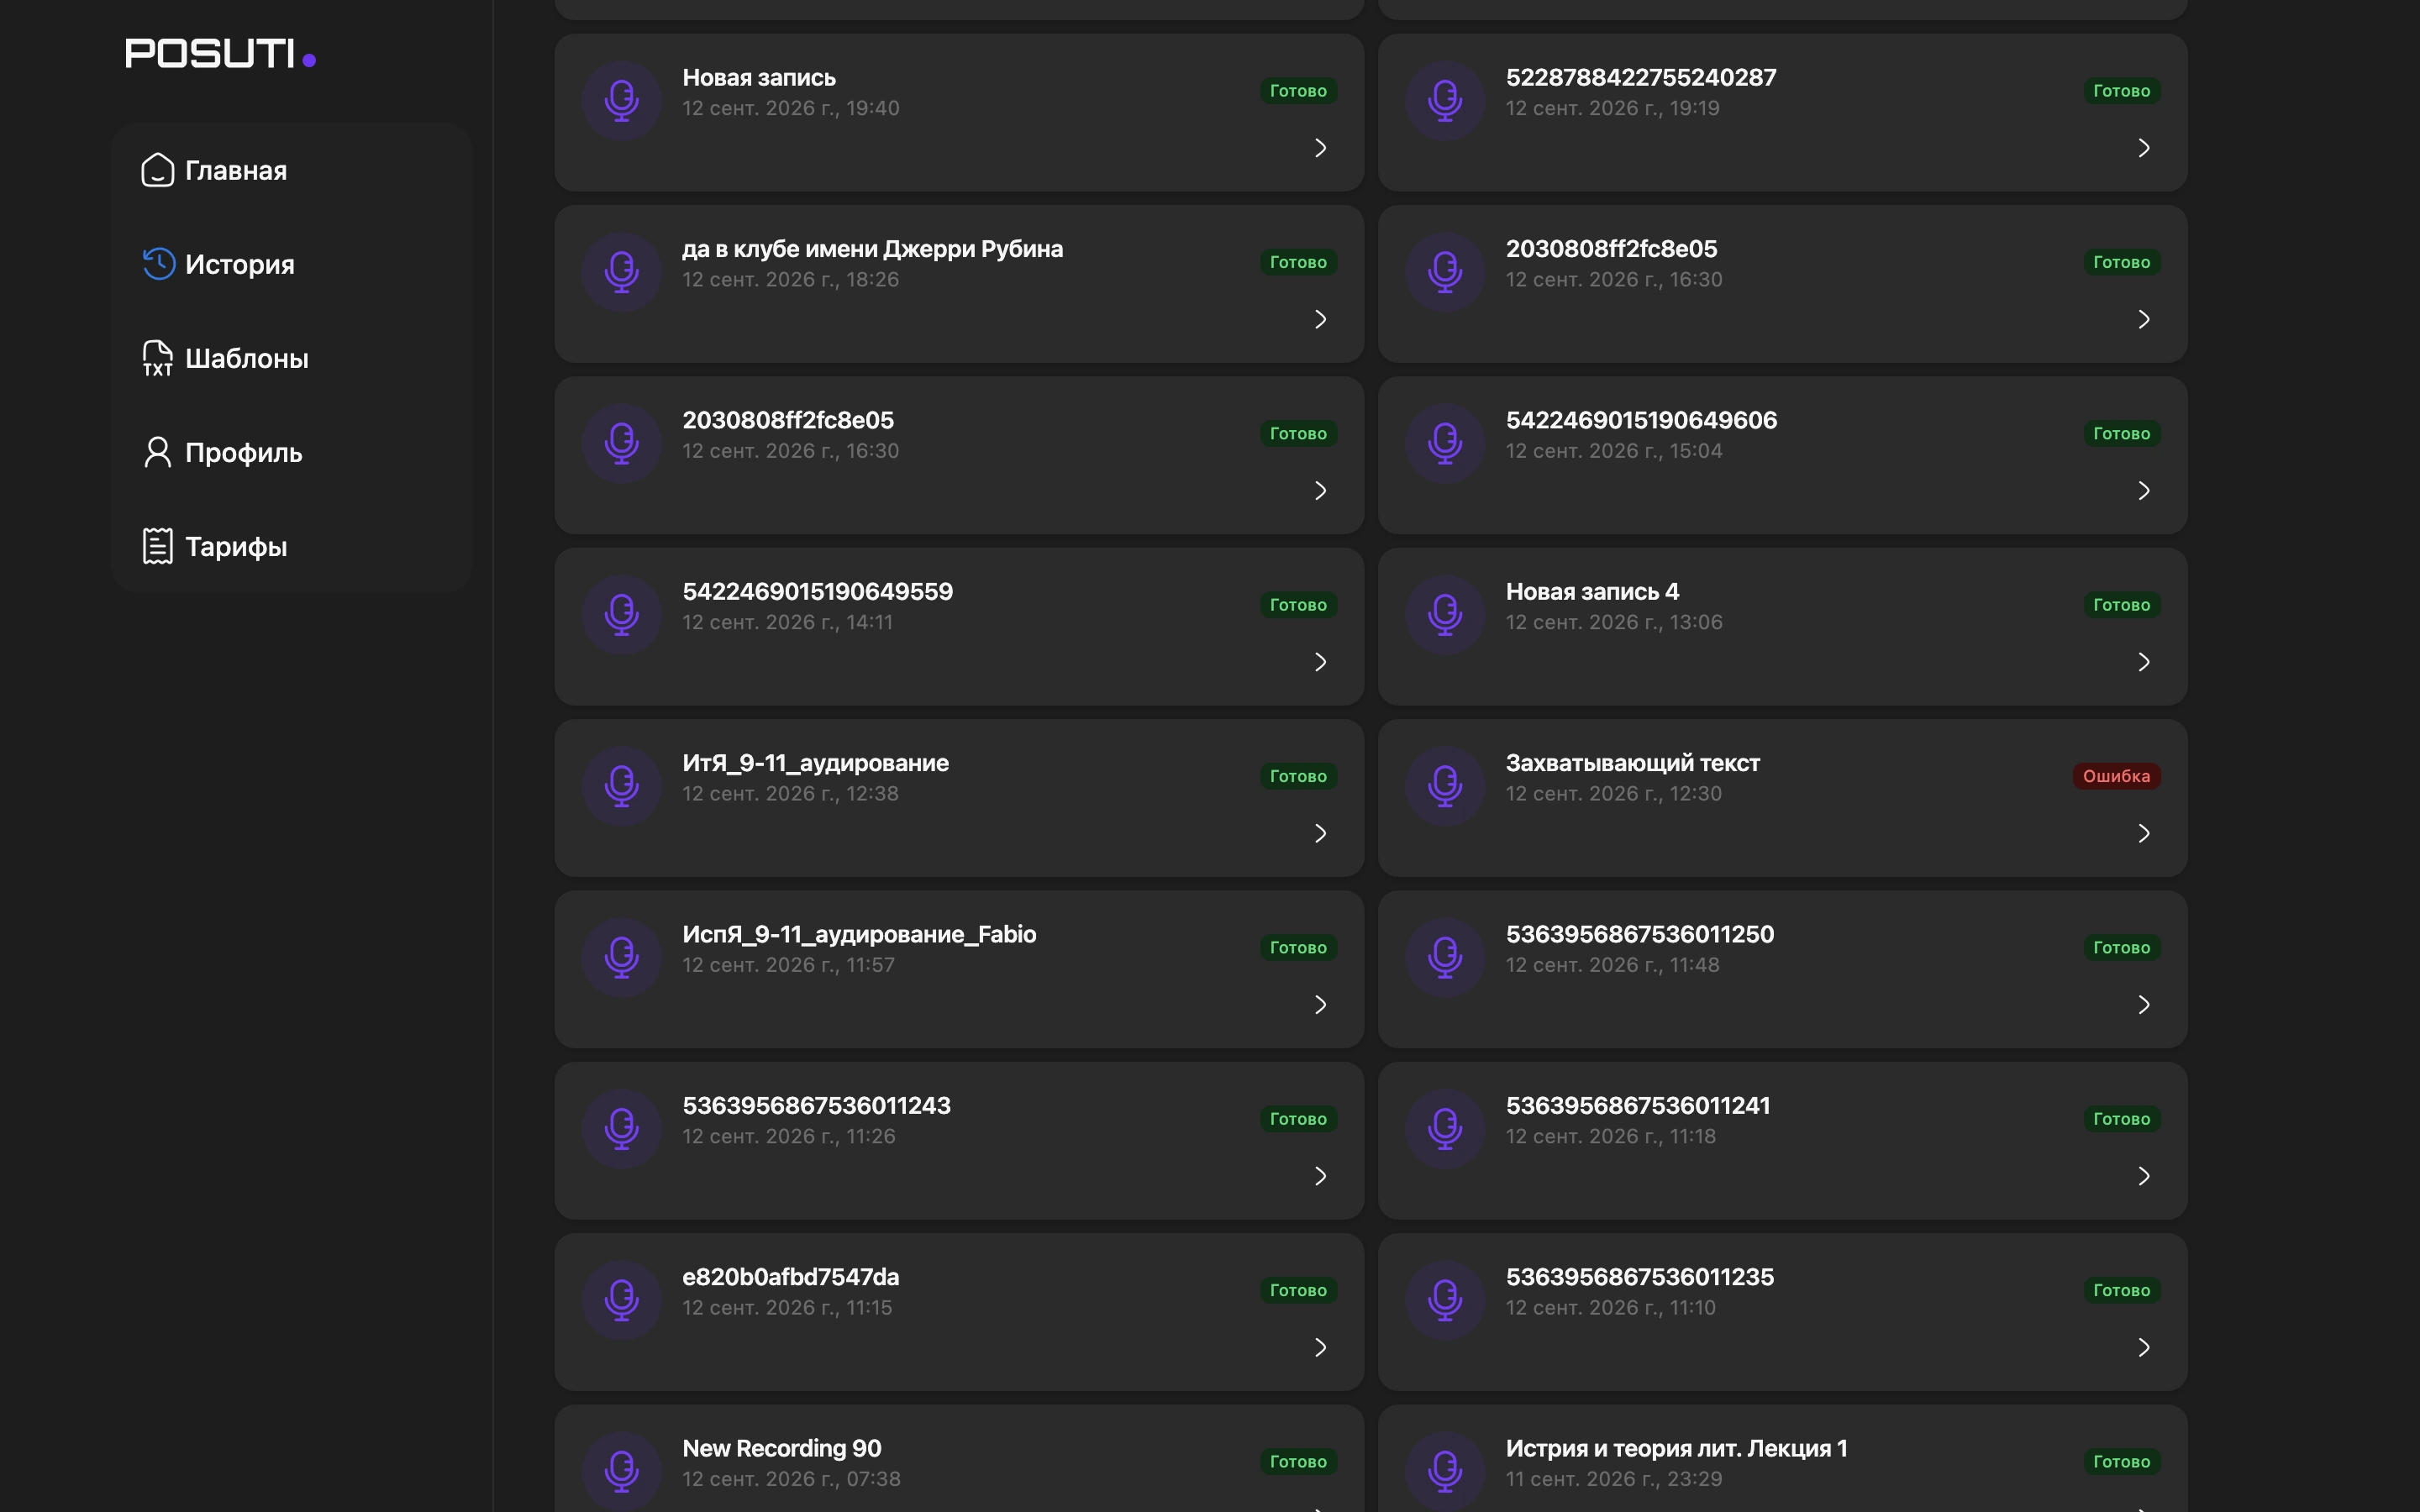
Расшифровка — первый шаг. Для работы с лекцией, интервью или встречей нужен результат под конкретную задачу: конспект, полный текст, решения и следующие действия. В POSUTI пользователь загружает запись, выбирает шаблон и получает структурированный материал.
Мой вклад: весь сервис
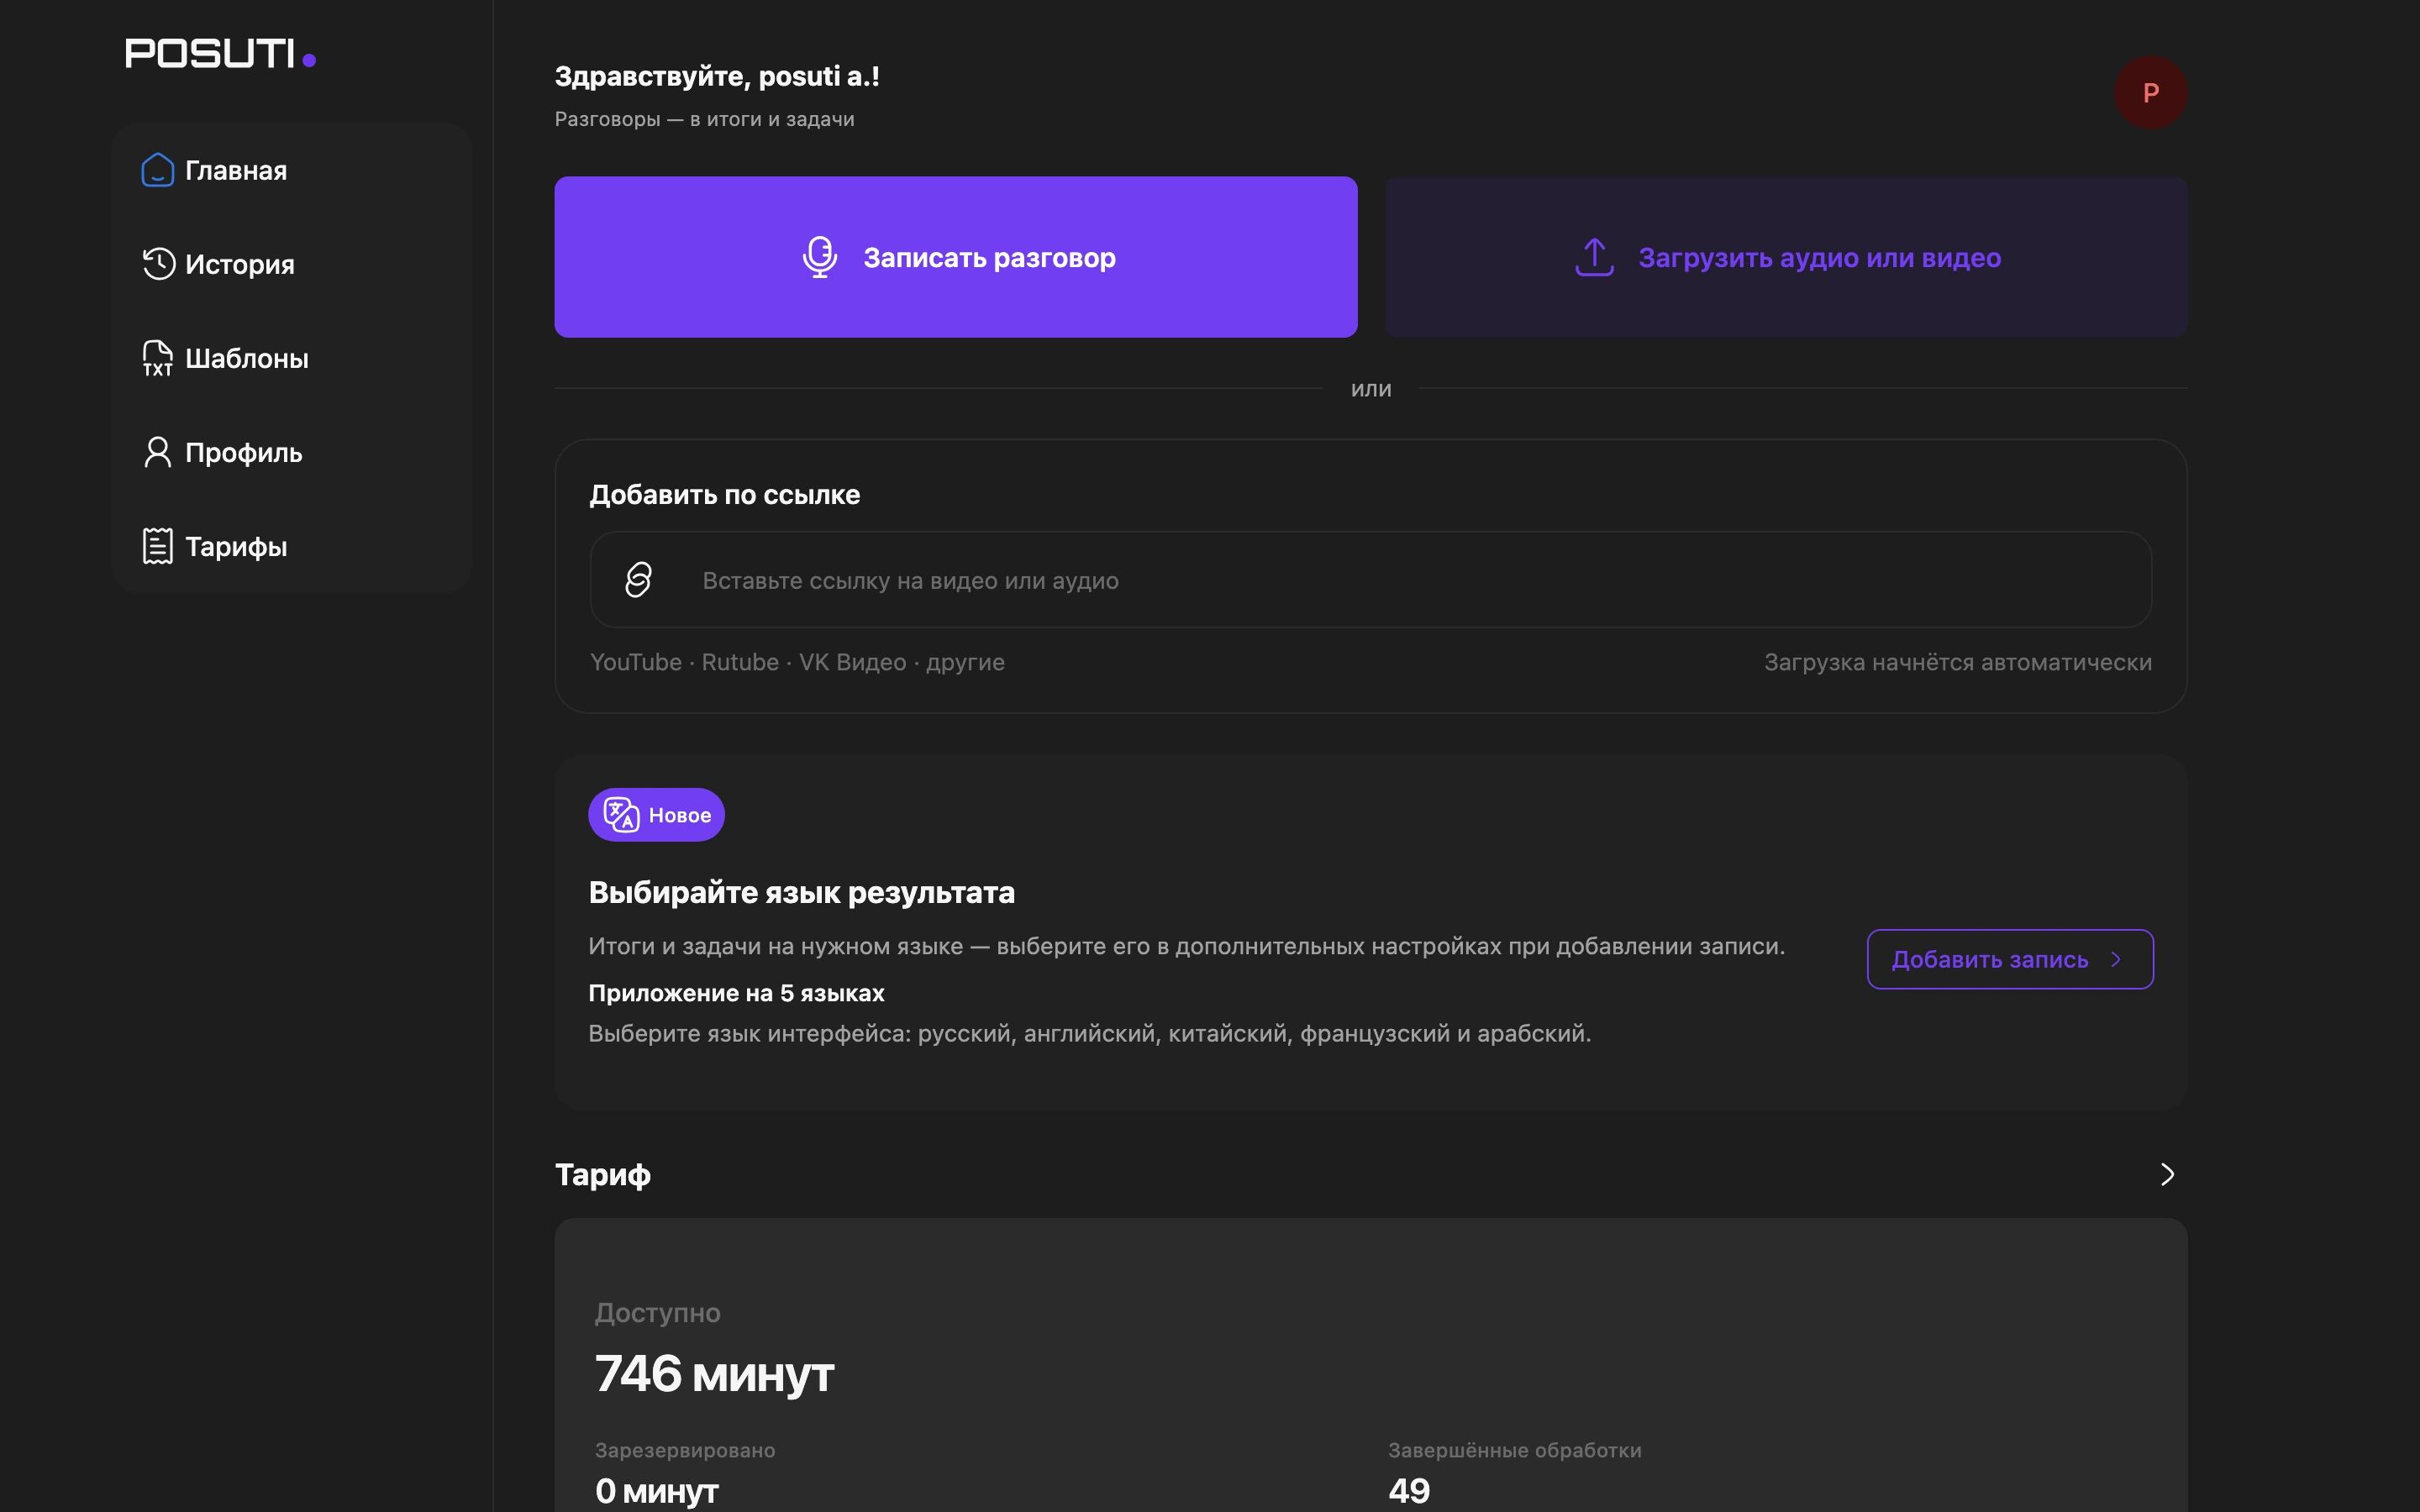
Самостоятельно разработал клиентскую часть на React и TypeScript, серверную часть на NestJS и сервис распознавания речи на Python. В приложении доступны загрузка записей, история обработки, шаблоны и экспорт результатов.
Помимо обработки аудио, в сервисе реализованы учётные записи, тарифы, учёт доступного времени обработки и платежи. Это части одного продукта: пользователь проходит путь от загрузки записи до получения результата.
Архитектура: распознавание и обработка текста
Распознавание речи вынесено в отдельный Python-сервис с FastAPI. В нём используются локальные модели T-one и faster-whisper, выбор которых зависит от языка записи. FFmpeg подготавливает аудио для обработки.
Длительная обработка организована через RabbitMQ; сервер хранит задания и управляет повторными попытками. Распознавание и оформление результата разделены: сохранённую расшифровку можно обработать по другому шаблону без повторного распознавания аудио.
Результат: работающий продукт
Сервис запущен и работает в промышленной эксплуатации. Пользователь получает не только расшифровку, но и материалы по выбранному шаблону: от конспекта лекции до итогов встречи. Доступен экспорт текста и субтитров.
Что стоит за результатом
POSUTI объединяет мой предпринимательский и инженерный опыт: я основал продукт, самостоятельно реализовал весь сервис и довёл его до промышленной эксплуатации.